AI POVibe CodingProduct AnalyticsDesign SystemMCP/CLI
PODO 앱 AI PO — End-to-End 스프린트 자동화 파이프라인
운영 중인 앱의 데이터 분석→PRD→프로토타입까지, 브라운필드 기반 AI-native 프로덕트 체계 구축
2025 - Present
2주
End-to-End 파이프라인 구축
1~2일
이터레이션 주기 (기존 1~2개월)
1.2M+
누적 유저 행동 데이터 분석
2h
디자인 병목 해소 (기존 2주)
Summary
운영 중인 언어 교육 앱(PODO)의 AI PO로서, 데이터 분석→PRD→프로토타입까지 1~2개월 걸리던 프로세스를 1~2일로 단축하는 End-to-End 스프린트 파이프라인을 단독 구축. 기존 시스템 위에 AI를 얹는 브라운필드 접근으로 팀 전체의 프로덕트 워크플로우를 AI-native로 전환.
01.배경 / 문제
영어/일본어 1:1 전화수업 앱(PODO)에서 AI-native 조직 전환을 시도 중이었으나 체계적인 프로세스가 부재했습니다.
PO 3명이 각자 스쿼드를 운영하는 구조였는데, 기능 간 연관성 파악이 안 되고 문제 발견부터 PRD, 프로토타입까지 1~2개월이 걸리는 상태였습니다. Figma 디자인 시스템 가이드가 정리되지 않아 프로토타입→디자인→개발 핸드오프에서 만성적인 병목이 발생하고 있었습니다.
AI PO로서 받은 미션은 AI-native 스프린트 체계를 구축하여 팀의 업무 속도를 높이고 앱의 완성도를 끌어올리는 것이었습니다. 합류 2주 만에 아래의 모든 시스템을 설계·구축했습니다.
02.A. Phase 0~6 End-to-End 스프린트 파이프라인
가장 먼저 한 건 흩어진 데이터를 한 곳으로 모으는 것이었습니다. GitHub 프론트엔드·백엔드 레포, Figma 디자인 시스템, Metabase + ClickHouse 유저 데이터, 구글 시트 운영 데이터까지 전부 MCP와 CLI로 연동하여 하나의 파이프라인 안에서 조회할 수 있게 만들었습니다.
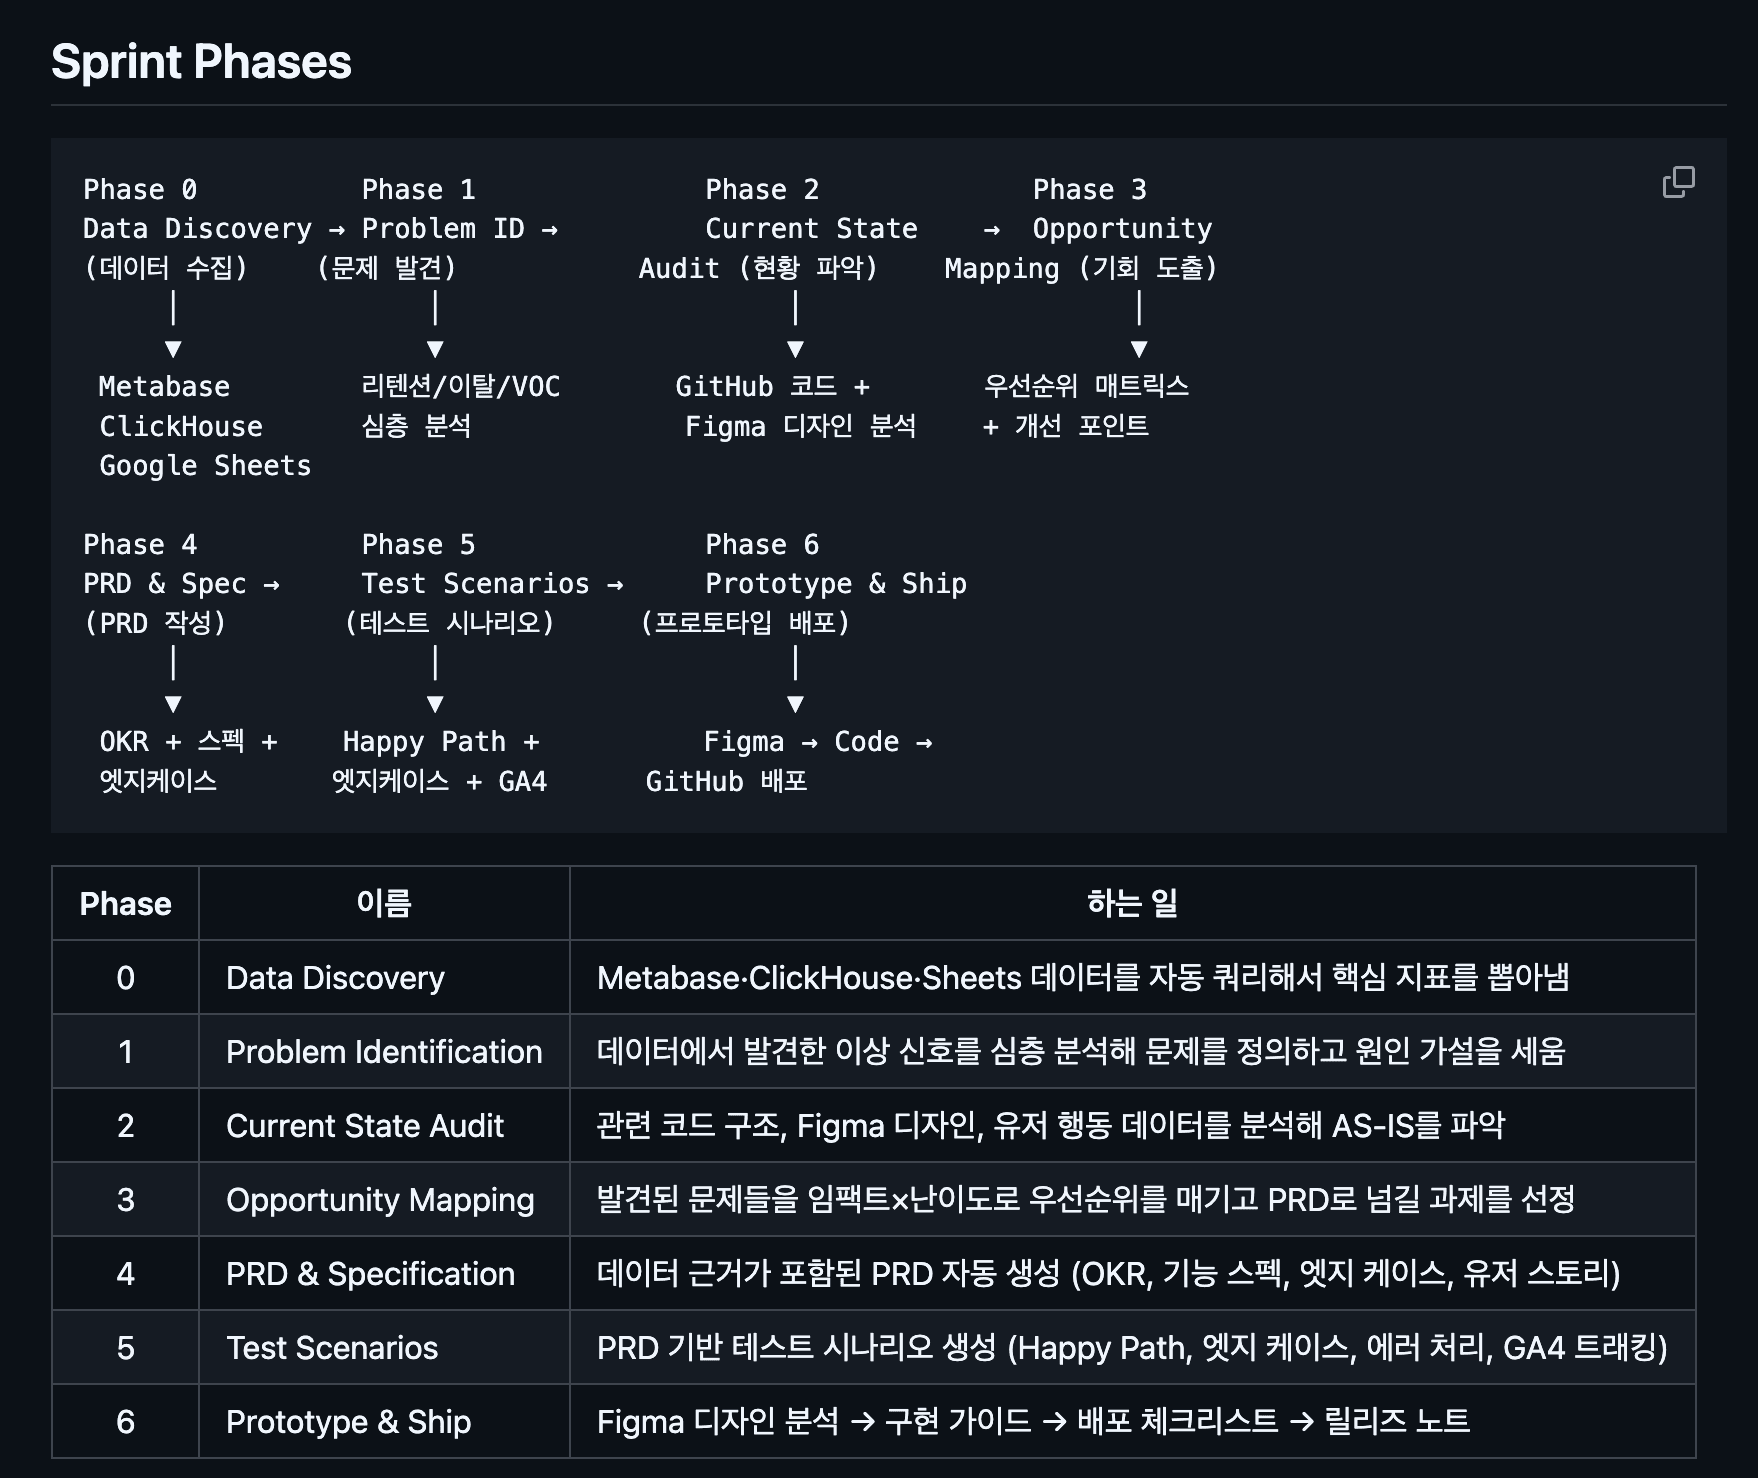
그 위에 Phase 0부터 6까지의 스프린트 파이프라인을 구축했습니다:
Phase 0. 데이터 디스커버리 — ClickHouse·Metabase를 Claude Code에 CLI/MCP로 연동, SQL·Python으로 분석 (일 12,000건·누적 120만+ 건)
Phase 1. 핵심 문제 도출 — 매출·리텐션·튜터 비용·VOC·온보딩 퍼널 등 8개 카테고리, 40건+ 심층 분석 문서 생성
Phase 2. 현재 화면 감사 — 30+ 화면의 UI 상태·플로우를 Mermaid 다이어그램과 마크다운으로 자동 문서화
Phase 3. 기회 영역 매핑 — Impact × Difficulty 매트릭스 기반 우선순위 도출, 스쿼드 간 의존성 매핑
Phase 4. PRD 자동 작성 — Phase 0~3 데이터를 자동 로딩하여 근거 기반 PRD + OKR + 기능 명세 생성
Phase 5. 테스트 시나리오 — PRD + 기술 제약 조건 기반 QA 시나리오 + 프리모템 리스크 분석 자동 생성
Phase 6. 프로토타입 — Storybook 기반 브라운필드 프로토타이핑 (22개 추출 컴포넌트 재활용)
각 Phase를 Claude Code 플러그인의 스킬로 만들어 한 명령어로 자동 실행되게 구성하고, Phase 간 컨텍스트 자동 로딩으로 이전 Phase의 분석 결과가 다음 Phase에 자동 반영됩니다.
직접 개발한 Phase 0~6 스프린트 파이프라인 — 각 Phase별 하는 일과 자동화 범위
03.B. 온톨로지 기반 검증 & 하네스 정밀화
파이프라인이 자동으로 결과물을 생성하더라도, 검증 없이는 신뢰할 수 없습니다. 개발자들이 먼저 구축해둔 온톨로지(서비스 구조·데이터 정의 문서)를 활용하여 매 Phase마다 정합성을 검증했습니다.
• 파이프라인이 도출한 문제와 PRD가 온톨로지와 정합성이 맞는지 확인
• 데이터 정의가 실제 서비스 구조와 일치하는지 매 Phase마다 크로스체크
• 불일치 발견 시 즉시 파이프라인 로직을 수정하여 정밀도 향상
이 파이프라인은 한 번 만들고 끝이 아니었습니다. 디자인/기획/데이터 하네스를 스프린트를 돌릴 때마다 계속 깎았습니다. 프로토타입을 만들어보면 디자인 쪽 제약이 보이고, PRD를 써보면 기획 쪽 구멍이 드러나고, 데이터를 뽑아보면 정의가 애매한 지표가 나옵니다. 그걸 하나하나 다듬어가면서 파이프라인 자체의 정밀도를 매 사이클마다 높여갔습니다.
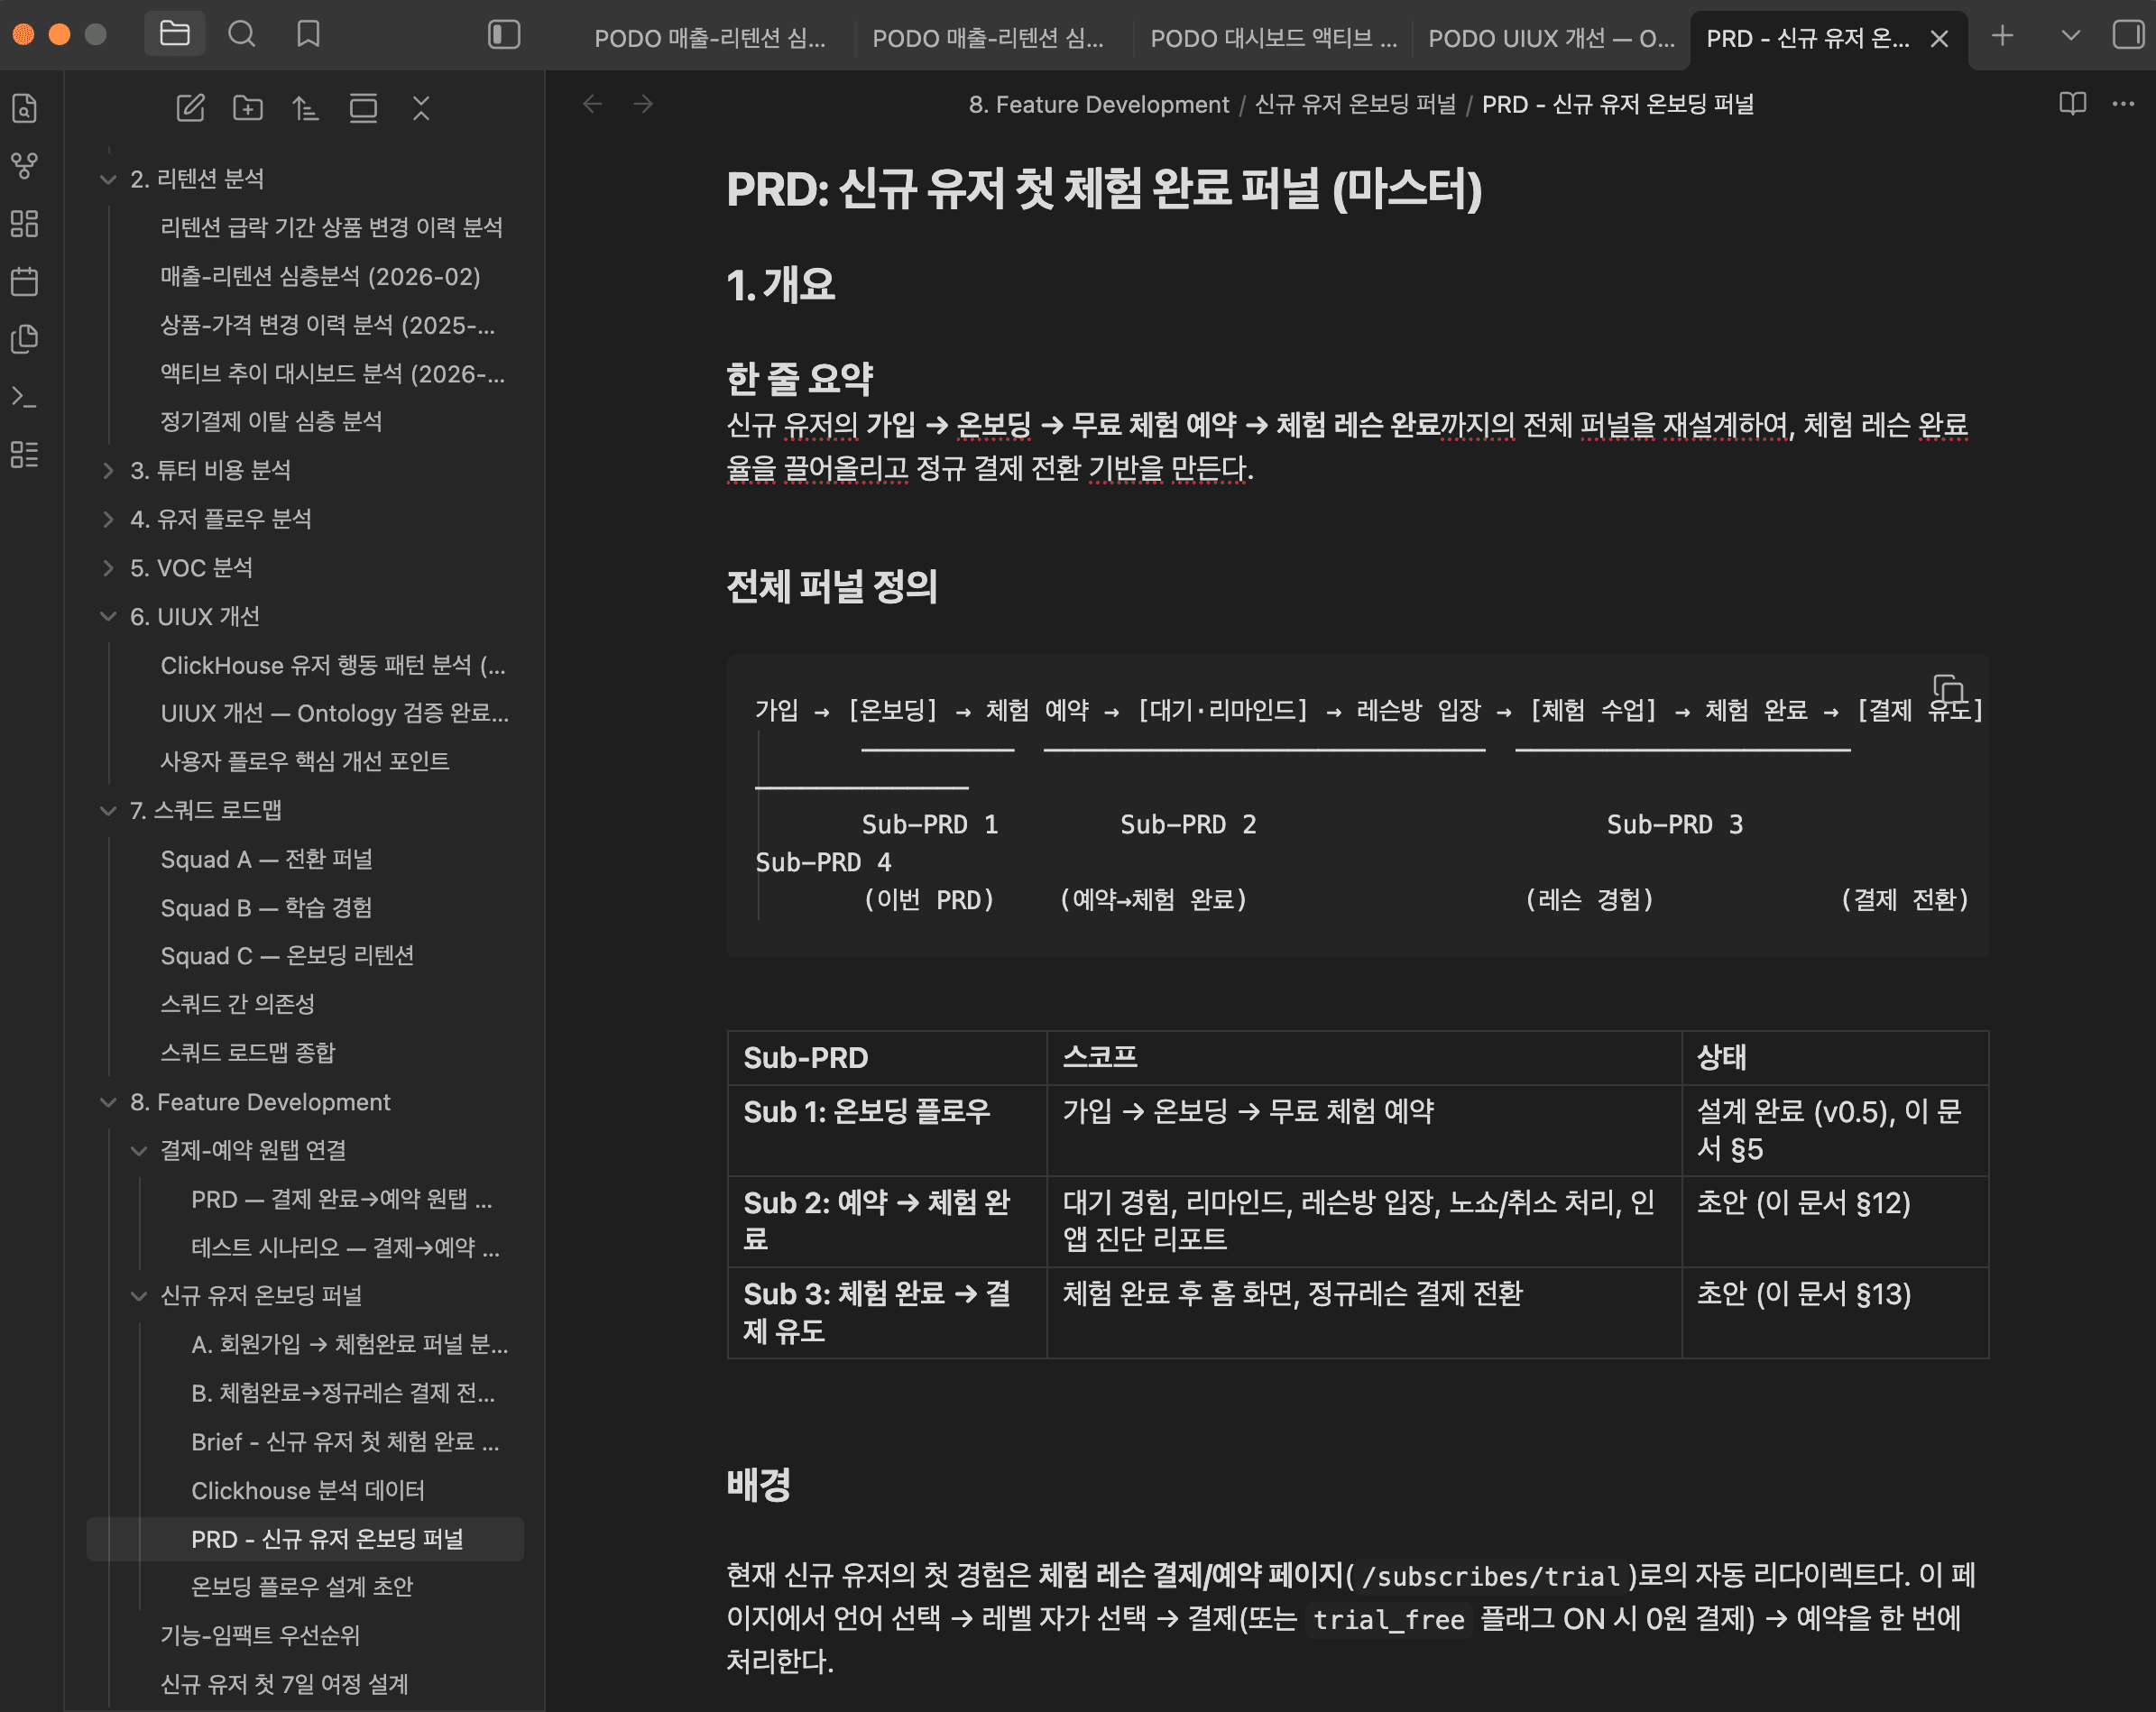
Obsidian으로 관리하는 파이프라인 산출물 — 데이터 분석·PRD·온톨로지 검증 문서
04.C. 디자인 시스템 자동 추출 & 바이브코딩 프로토타입
Figma 디자인 시스템 가이드가 존재하지 않아 개발자가 매번 디자인 의도를 추정해야 했고, 이로 인해 PO→디자이너→개발자 핸드오프에서 만성적인 병목이 반복 발생하고 있었습니다.
Figma MCP와 코드베이스 분석을 결합하여 디자인 시스템을 자동 추출·정리하고 2시간 만에 해소했습니다:
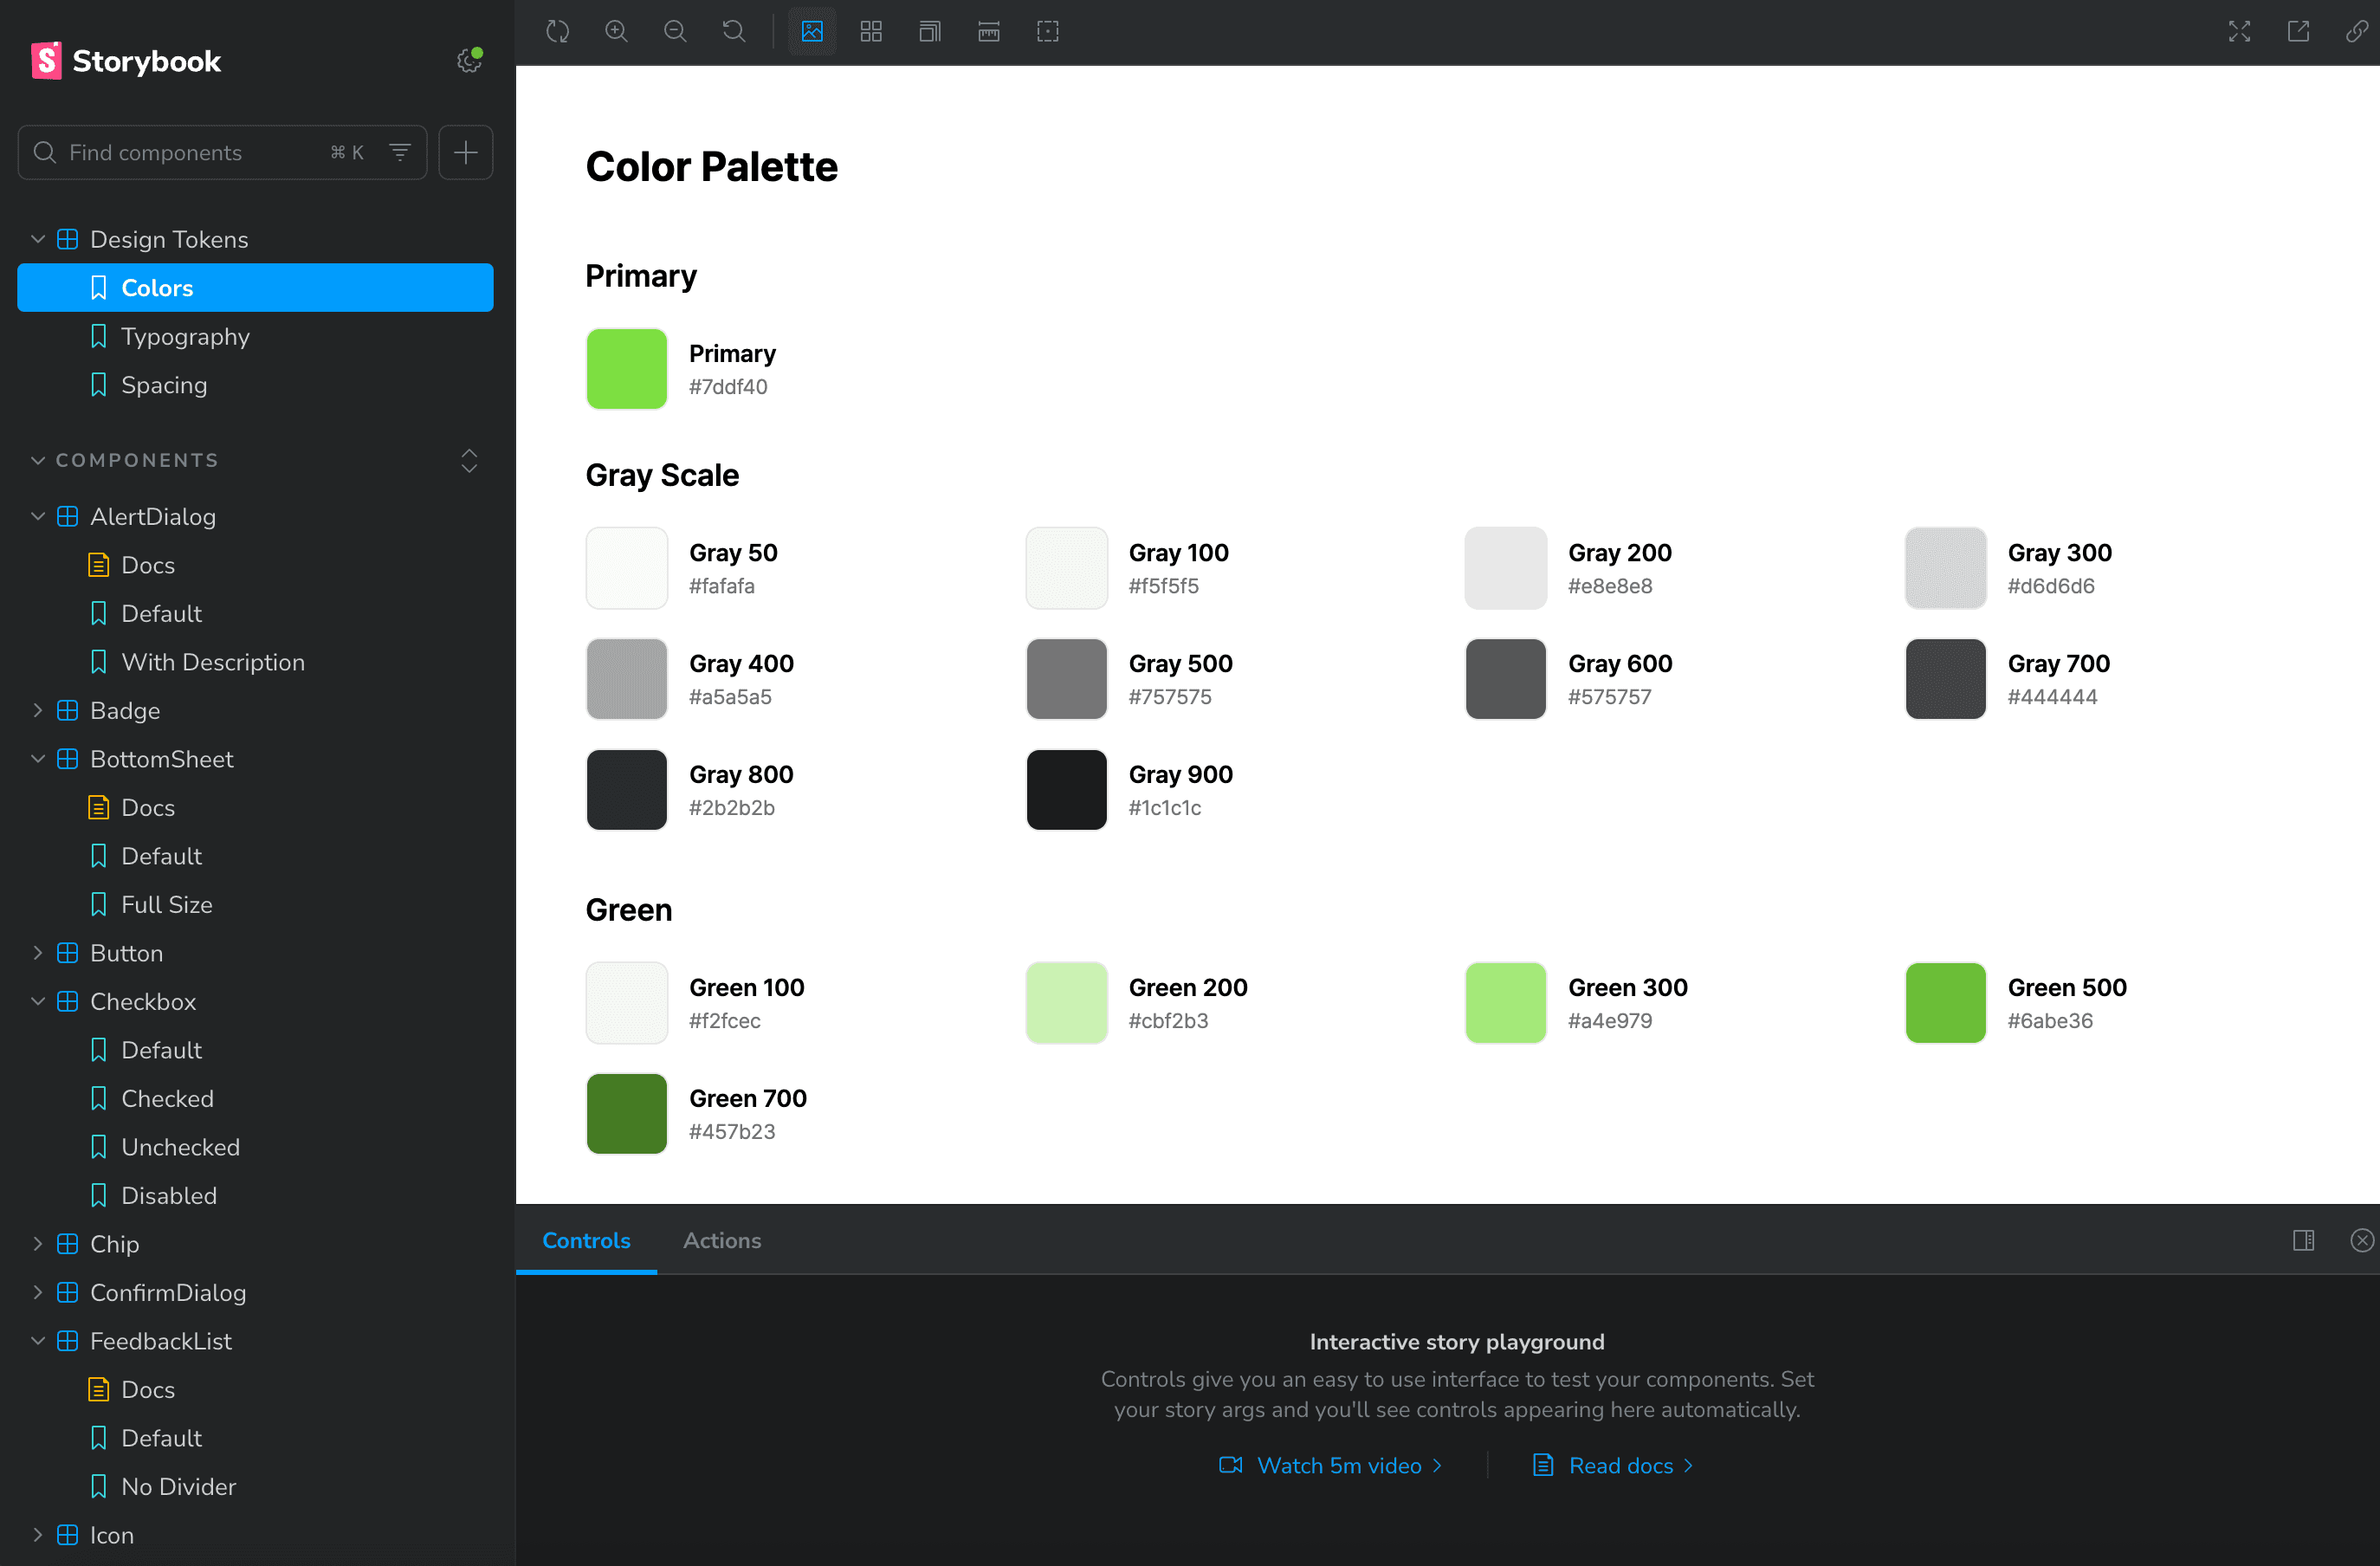
• Figma MCP로 디자인 파일의 컴포넌트·스타일을 자동 조회하고, 프론트엔드 코드베이스에서 실제 구현체(컬러·타이포그래피·스페이싱)를 자동 파싱하여 22개 컴포넌트의 Storybook 카탈로그 구축
• 디자인 토큰 가이드(colors, typography, spacing) + 컴포넌트 사용 가이드 + 글로벌 레이아웃 규칙 등 개발자용 가이드 문서 3종 자동 생성
• 30+ 화면의 UI 플로우를 Mermaid 다이어그램으로 문서화하고, 79개 스크린을 커버하는 인터랙티브 UX 플로우맵 프로토타입 제작
• Figma 디자인 파일과 화면 문서 간 자동 링킹 시스템 구축 (node-id 기반 22개 화면 자동 매핑)
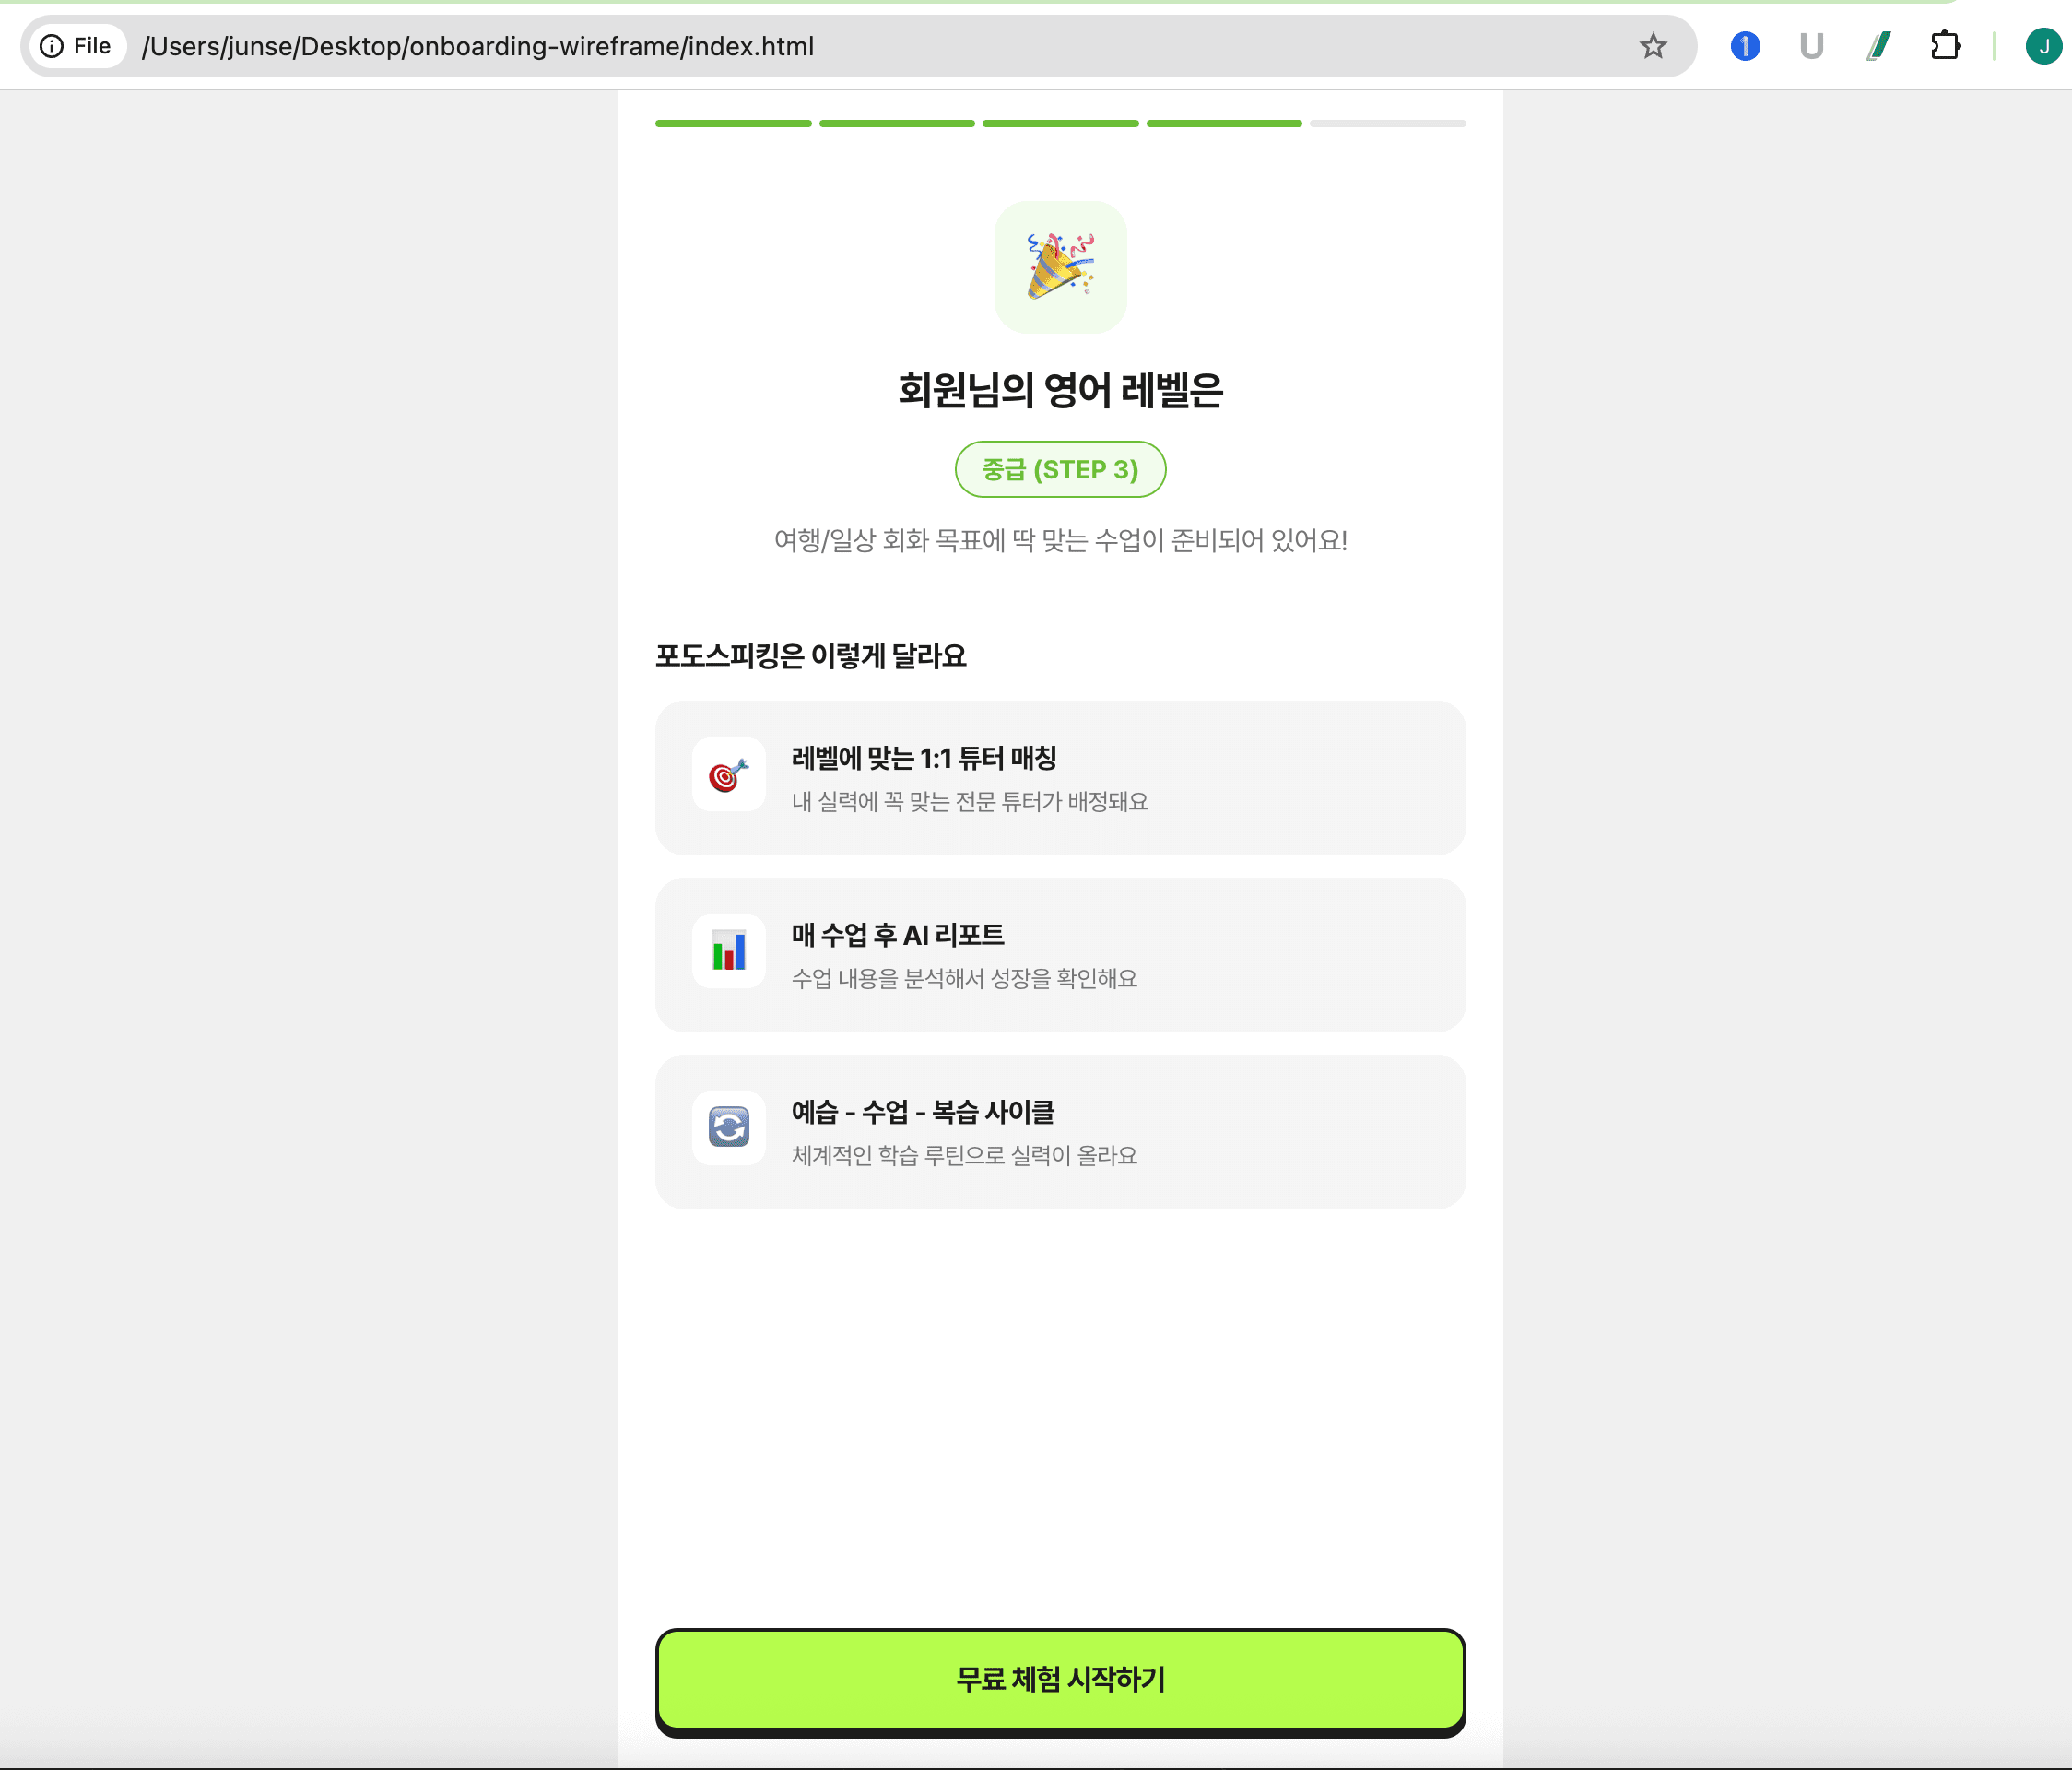
• 추출된 디자인 시스템을 기반으로 바이브코딩 프로토타입 자동 생성 환경을 구축하여 PO→디자이너·개발자 핸드오프 효율화
Storybook 기반 디자인 시스템 — 22개 컴포넌트 자동 추출 카탈로그
바이브코딩 프로토타입 — 온보딩 레벨 테스트 결과 화면
05.임팩트 / 결과
합류 2주 만에 전체 시스템을 단독 설계·구축하여 팀의 일하는 방식을 전환
• 문제 발견→PRD→프로토타입 사이클: 1~2개월 → 1~2일로 단축
• 프로토타입→디자인→개발 만성적 핸드오프 병목 → 디자인 시스템 자동 추출 + 바이브코딩으로 해소
• 데이터 기반 문제 발견과 백로그는 풍부했지만 임팩트 우선순위를 정하지 못하던 구조 → 프로덕트 로드맵과 스쿼드 간 의존성 맵을 설계하여 3개 스쿼드(전환 퍼널·학습 경험·온보딩 리텐션)의 OKR 정렬 지원
• 각 PO가 개별 스쿼드만 보던 사일로 구조 → 팀 전체가 처음으로 앱 전체의 문제점·우선순위·기능 간 연관성을 한눈에 파악 가능
• 2주 내 전체 End-to-End 파이프라인 단독 설계·구축 완료
06.의사결정 포인트
이 프로젝트에서 핵심적인 의사결정은 세 가지였습니다.
첫째, Brownfield 접근을 선택했습니다. 새로 만드는 것이 아니라 기존 시스템(코드베이스·디자인 시스템·데이터 인프라) 위에 AI를 얹는 것이 실무에서 훨씬 높은 가치를 가집니다. 기존 온톨로지를 검증 체계로 활용한 것도 같은 맥락입니다.
둘째, 하나의 거대한 자동화가 아닌 Phase별 분리 + 반복 정밀화 구조를 선택했습니다. 전부 완벽하게 만들겠다는 욕심을 버리고, '일단 돌아가는 것'부터 만든 뒤 온톨로지로 검증하고, 하네스로 다듬고, 다시 돌리는 사이클을 반복했습니다. 이 접근이 1~2개월 걸리던 프로세스를 1~2일로 단축할 수 있었던 핵심입니다.
셋째, Human-in-the-loop을 의도적으로 유지했습니다. 디자인과 개발은 전문 인력에게 맡기고, PO가 PRD를 확인·다듬은 후 프로토타입을 진행하는 구조로 설계하여, AI가 대체하는 것이 아니라 PO의 판단력을 증폭시키는 도구로 포지셔닝했습니다.